Gue cuma mau mindahin sambungan kabel LAN. Dari router Biznet ke router Xiaomi. Harusnya pekerjaan yang selesai sebelum sempat kepikiran bikin kopi.
Yang gue dapat malah Cloudflare Error 1033.
Blog ini nggak bisa dibuka. Mobileague ikut nggak bisa diakses. Tailscale sempat putus. Dari sisi gue yang lagi mau masuk ke server, rasanya semua service kompak menghilang.
Padahal gue nggak lagi deploy aplikasi. Nggak migrasi database. Nggak ngubah kode.
Cuma kabel LAN.

Setelah ngoprek router Xiaomi buat OpenWrt, ternyata masih ada ujian yang bentuknya lebih sederhana: memastikan sambungannya beneran nyambung. Wkwk.
Cloudflare Error 1033 Itu Kenapa?
Server homelab gue namanya Monarki. Isinya Debian, beberapa container Docker, blog ini, dan Mobileague. Akses publik kedua website lewat Cloudflare Tunnel.
Jalurnya kira-kira begini:
Pengunjung → Cloudflare → Tunnel → Monarki → website
Di Monarki ada proses cloudflared yang menjaga koneksi ke Cloudflare. Kalau jalur keluar server bermasalah, koneksi itu ikut hilang.
Menurut dokumentasi Cloudflare, error 1033 muncul ketika Cloudflare nggak menemukan instance cloudflared yang sehat untuk menerima traffic. Jadi melihat halaman error ini belum cukup buat menyimpulkan aplikasinya crash.
Dan itu persis hal yang perlu gue bedain malam itu: website nggak bisa diakses, tapi proses aplikasinya belum tentu mati.
Waktu akses ke server balik dan kita cek, container masih jalan. Blog dan Mobileague sama-sama membalas HTTP 200 dari dalam server. Yang sempat putus adalah jalur jaringan menuju dunia luar.
Semua service terasa mati bareng karena jalan masuknya yang hilang. Ternyata mesin di rumah masih sibuk kerja, cuma gue nggak bisa nyamperin.
Ternyata Gangguannya Sudah Mulai Jam Tiga Sore
Gue ngerjain pengecekan ini bareng Codex. Gue yang mindahin kabel dan kasih hasil percobaan, Codex bantu baca konfigurasi, log, dan ngetes jalurnya.
Awalnya gue cuma punya halaman error yang kelihatan malam hari. Setelah riwayat tunnel ditarik, waktunya jadi lebih jelas.
Ini catatan 2 November 2026, semuanya dalam WIB:
| Waktu | Yang tercatat |
|---|---|
| 15:17:32 | Keempat koneksi tunnel melaporkan network is unreachable |
| 21:31:50 | Waktu pada halaman error 1033 yang gue lihat |
| 21:38:36 | Setelah balik ke Biznet, DHCP selesai mendapatkan alamat dan default route |
| 21:38:54 | Koneksi tunnel pertama berhasil tersambung lagi |
| 21:39:31 | Keempat koneksi tunnel sudah kembali |
Jarak dari gangguan jaringan yang tercatat sampai koneksi tunnel pertama balik: sekitar enam jam dua puluh satu menit.
Iya. Gue baru ribut malamnya, padahal log sudah teriak dari sore.
Angka itu berdasarkan riwayat koneksi tunnel, bukan hasil monitor uptime yang sudah jalan dari pagi. Waktu itu gue memang belum punya monitor eksternal yang bisa langsung ngabarin. Bagian terakhir ini yang akhirnya bikin gue mikir: masa harus nunggu gue iseng buka website dulu baru ketahuan?
Gue Sempat Curiga DHCP Debian
Pertanyaan pertama gue lumayan masuk akal: pindah router berarti pindah jaringan. Apa DHCP di Debian belum aktif? Apa alamat IP lama nyangkut?
Ternyata konfigurasinya sudah begini:
allow-hotplug enp6s0
iface enp6s0 inet dhcp
DHCP aktif. Client dhcpcd juga jalan.
Nama allow-hotplug sempat bikin pembahasannya muter. Kita sempat terlalu cepat menduga Debian nggak bereaksi saat kabel dipindah. Setelah lihat proses yang aktif dan log-nya, dugaan itu harus dikoreksi: dhcpcd di Monarki justru mendeteksi koneksinya datang dan pergi.
Masalahnya, pergi terus.

Potongan log yang berulang bentuknya seperti ini:
21:34:11 enp6s0: carrier lost
21:34:12 enp6s0: carrier acquired
21:34:13 enp6s0: carrier lost
21:34:15 enp6s0: carrier acquired
Pola begitu berlangsung berkali-kali. Link Ethernet naik, lalu jatuh lagi satu atau dua detik kemudian. Kebayang DHCP lagi berusaha beresin urusan alamat, sambungannya sudah keburu putus duluan.
Jadi langkah berikutnya bukan asal install network manager baru atau restart semua container. Yang perlu diperiksa dulu justru koneksi Ethernet-nya: kabel, konektor, port router, atau proses negosiasi link.
Apakah kabelnya pasti rusak? Belum bisa gue bilang. Log membuktikan link putus-nyambung. Log nggak bisa nunjuk siapa yang nyabut kabel, atau memastikan komponen mana yang bermasalah. Gue nggak mau bikin vonis hardware cuma modal kesel.
Balik ke Biznet, Lalu Coba Xiaomi Lagi
Percobaan pertama yang bikin akses kembali adalah memindahkan kabel ke Biznet lagi. Ini penting: pulih setelah balik ke router lama belum membuktikan perpindahan ke Xiaomi sudah berhasil.
Setelah itu baru kita tes ulang ke Xiaomi.
Kali ini Monarki berhasil mendapatkan alamat di jaringan Xiaomi, default gateway-nya ikut berubah, SSH lewat LAN bisa masuk, dan Tailscale tersambung lagi. Ping ke gateway juga nggak kehilangan paket dalam pengujian singkat itu.
Selama sekitar dua setengah menit pengamatan, penghitung perubahan link nggak bertambah. Kedua website membalas 200, lalu semua koneksi Cloudflare Tunnel kembali.
Artinya, Monarki bisa pindah router dengan DHCP yang sudah ada. Kita nggak perlu menambahkan port forwarding atau mengutak-atik aplikasi supaya percobaan itu berhasil.
Tapi gue juga nggak mau mengubah tes dua setengah menit jadi klaim “aman selamanya”. Penyebab pasti link yang tadi putus-nyambung belum berhasil diisolasi. Kalau kejadian lagi, kabel yang sudah terbukti bagus dan port LAN lain jadi tes pertama.
Monitor Jangan Ikut Mati Bareng yang Dimonitor
Setelah koneksinya enakan, gue kepikiran pasang Uptime Kuma. Bisa cek website, terus kirim pesan ke Telegram kalau down.
Lalu ada satu masalah yang kelihatannya sepele: kalau monitornya gue taruh di Monarki juga, siapa yang kirim pesan ketika Monarki mati?
Atau ketika internet rumah putus?
Server lain di rumah pun masih bisa ikut kehilangan jalur keluar kalau memakai router dan koneksi internet yang sama. Uptime Kuma tetap berguna buat banyak kebutuhan, tapi untuk kasus gue, titik pemantaunya perlu berada di luar rumah.
Gue akhirnya pakai Cloudflare Workers, dengan Cron Triggers untuk menjalankan pengecekan berkala. Worker ini hidup di Cloudflare, jadi nggak ikut bergantung pada kabel LAN Monarki.
Perannya beda dari Cloudflare Tunnel tadi. Tunnel membawa traffic ke website gue. Worker mengecek apakah website itu masih bisa dijangkau, lalu menghubungi Telegram kalau pengecekannya gagal terus.
Cloudflare Worker → cek website lewat internet
                  → simpan hasil di D1
                  → kirim alert ke Telegram kalau gagal berulang
Lima Menit Sekali, Tapi Jangan Bikin Telegram Berisik
Gue pilih aturan yang sederhana:
- Cek dua website setiap lima menit.
- Tiga kali gagal berturut-turut baru kirim alert, per website.
- Satu alert per kejadian, bukan satu pesan tiap lima menit selama masih down.
- Kalau pulih, status direset diam-diam. Notifikasi recovery gue matikan.
- Senin pukul 09.00 WIB, kirim ringkasan uptime mingguan.
Dengan interval itu, alert biasanya muncul sekitar 10–15 menit setelah gangguan mulai, ditambah waktu timeout atau keterlambatan scheduler. Buat homelab gue, komprominya masuk akal. Nggak terlalu lambat, tapi nggak langsung panik gara-gara satu request gagal.
Statusnya disimpan di Cloudflare D1, database yang berbasis SQLite. Jadi Worker ingat berapa kali sebuah website gagal dan apakah alert untuk kejadian itu sudah dikirim.
Riwayat pengecekan disimpan selama 90 hari. Laporan mingguannya mencakup persentase pengecekan yang berhasil, periode kegagalan, perkiraan waktu tidak tersedia, waktu respons, dan kelengkapan sampel. Kalau ada pengecekan yang nggak tercatat, itu dianggap belum diketahui, bukan otomatis dihitung sebagai downtime.
Laporan pertama dijadwalkan 9 November 2026. Isinya tentu hanya riwayat yang terkumpul sejak monitor dipasang. Gue nggak tiba-tiba punya data uptime seminggu penuh cuma karena tabelnya baru dibuat.
Jangan Sampai yang Dicek Cuma Halaman Cache
Ada detail kecil yang gue suka dari setup ini. Website di belakang CDN bisa saja masih menampilkan halaman cache saat server asalnya bermasalah.
Makanya kita bikin endpoint kesehatan kecil di masing-masing website. Responsnya diberi Cache-Control: no-store. Setiap pengecekan juga membawa kode acak, dan respons origin harus mengembalikan kode yang sama.
Kalau yang nyampe cuma jawaban lama dari cache, kodenya nggak cocok. Nggak dihitung sehat.
Untuk blog, yang dicek adalah nginx yang melayani situs. Untuk Mobileague, pengecekannya diteruskan ke endpoint kesehatan frontend. Ini belum berarti semua isi database, semua artikel, CPU, RAM, dan seluruh container sudah dipantau. Cakupannya jelas: dua website dan jalur akses ke origin-nya.
Akhirnya Telegram Gue Bunyi
Ada drama kecil sebelum beres: bot Telegram pertama ternyata sudah gue pakai buat PicoClaw. Kita nggak lanjut memakai bot itu; gue ganti ke bot lain dan kirim /start supaya chat pribadinya bisa diidentifikasi.
Setelah bot baru terhubung, pesan tes ini masuk:
✅ Monarki monitor is connected.
Checks: every 5 minutes.
Alerts: after 3 consecutive failures, once per outage.
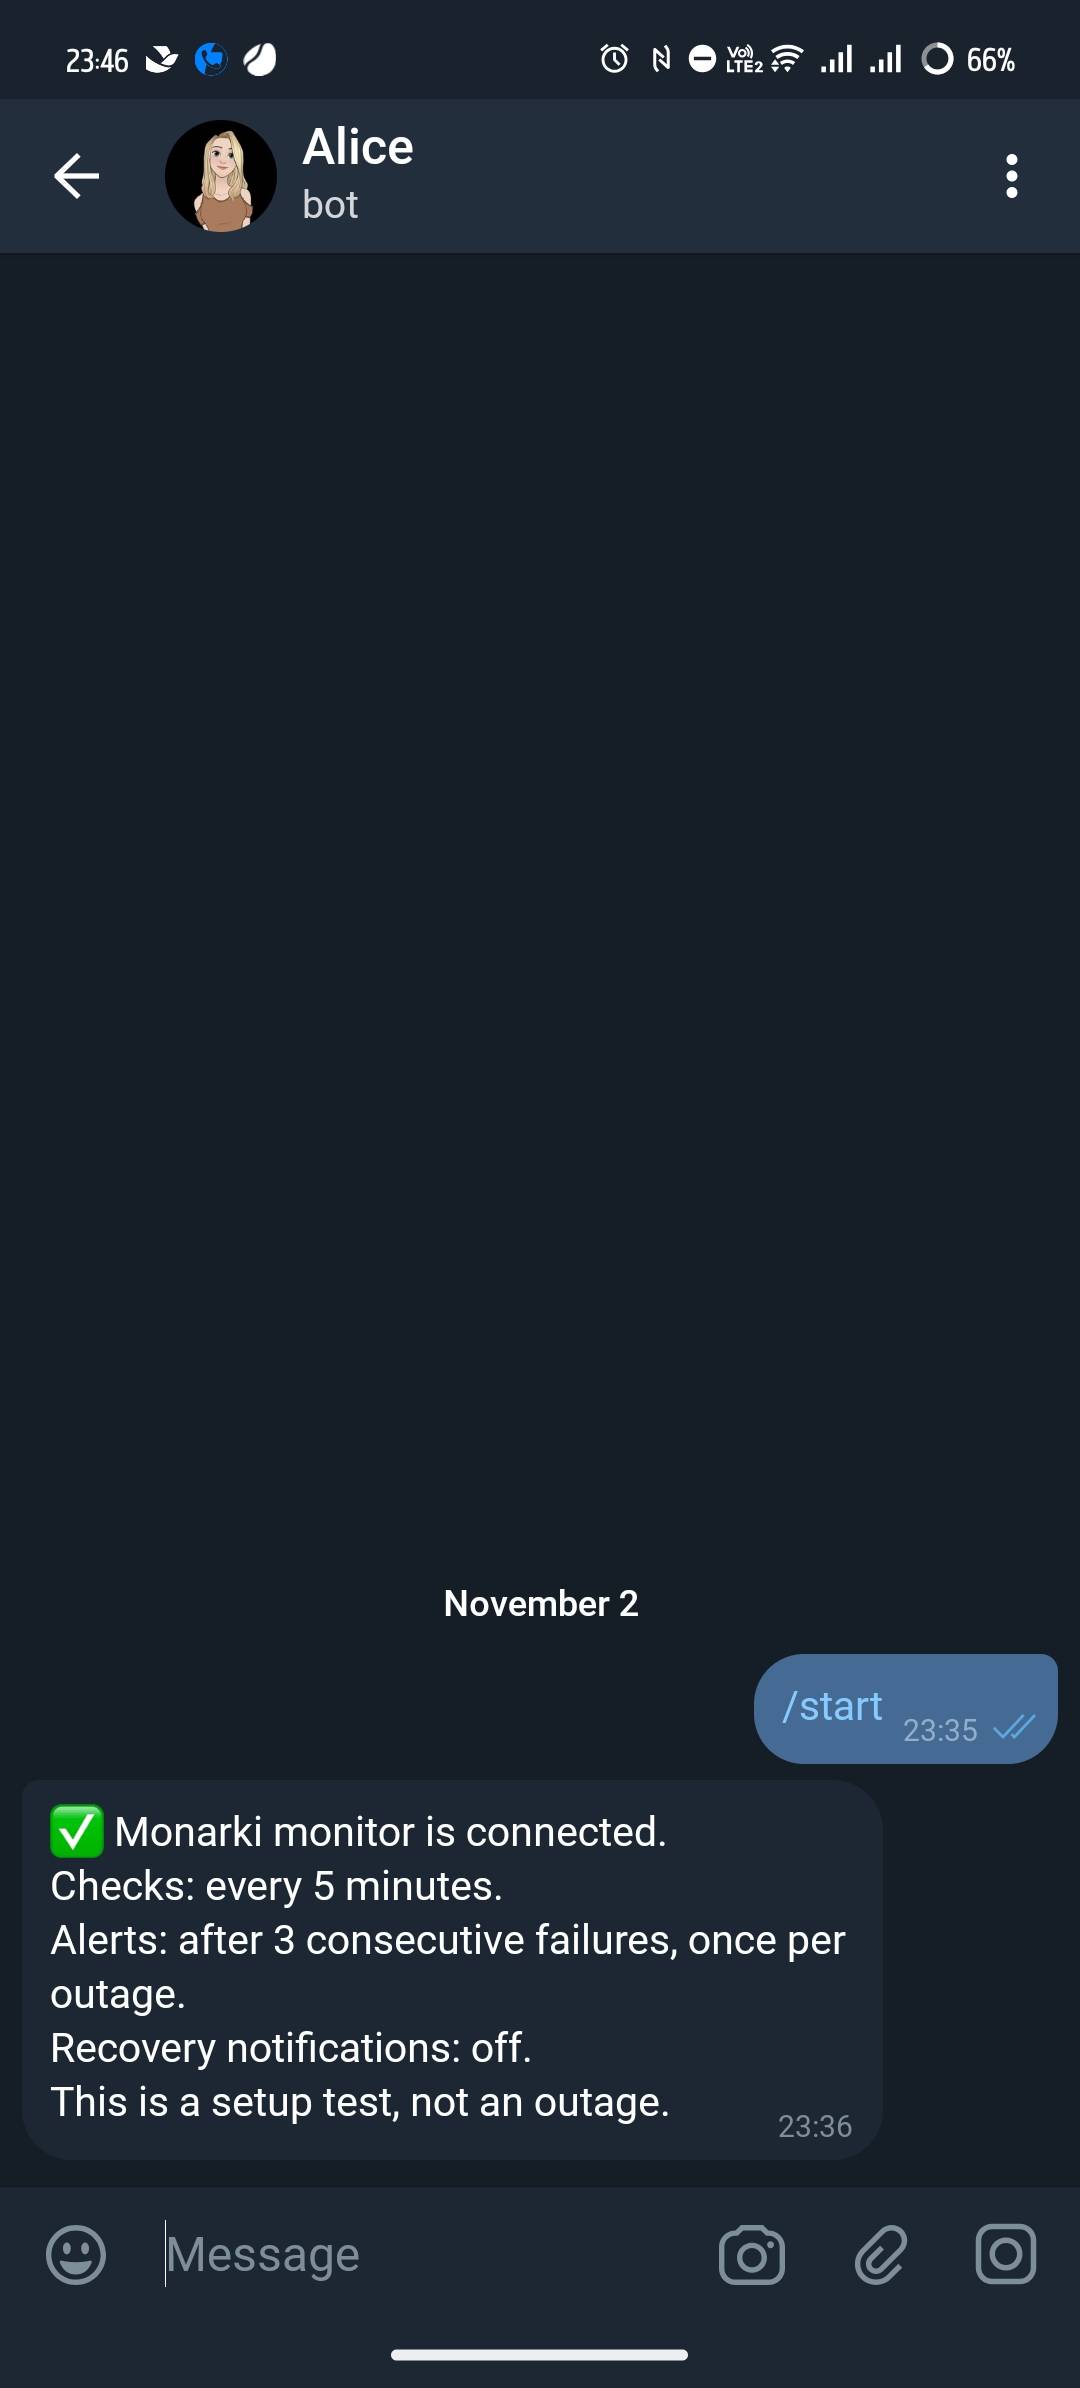
Kita juga ngetes logikanya: kegagalan tiga kali, pesan yang nggak dobel, recovery yang diam, retry kalau pengiriman Telegram gagal, sampai hitungan laporan mingguan. Sebelas tes lolos.
Terus gue tunggu pengecekan otomatisnya beneran jalan. Pada 23.46 WIB, kedua website lolos dari pemeriksaan Worker dan hasilnya tersimpan di D1.
Baru di situ gue merasa setup-nya beres. Pesan tes sudah nyampe, pengecekan otomatis sudah kejadian, dan datanya ada. Bukan cuma tombol “enable” yang kelihatan aktif.
Biayanya Berapa?
Untuk ukuran setup ini, nggak perlu VPS tambahan atau mengaktifkan paket Workers berbayar.
Pengecekan lima menit sekali berarti 288 eksekusi terjadwal per hari untuk monitor, atau 576 request ringan ke dua website. Ada tambahan laporan mingguan dan operasi database kecil untuk menyimpan hasilnya.
Pemakaian ini muat di free tier saat setup dibuat, dengan tetap memperhitungkan kuota akun yang dipakai workload lain. Angka dan batasnya bisa dicek di halaman harga resmi Cloudflare Workers dan D1. Gue sengaja nggak bikin janji “gratis selamanya”; yang bisa gue pastikan adalah kebutuhan monitor gue sekarang nggak memerlukan upgrade paket.
Sekarang Gue Nggak Harus Nunggu Iseng Buka Website
Yang bikin koneksi pulih tetap jalur jaringan yang kembali stabil. Cloudflare Worker nggak bisa membetulkan kabel LAN atau memasangnya lagi ke router.
Tapi sekarang kalau akses website hilang terus, ada sistem di luar rumah yang bisa ngabarin lewat Telegram. Itu perbedaan yang lumayan besar dibanding baru sadar berjam-jam kemudian.
Gue juga belajar buat nggak buru-buru menyalahkan DHCP, Cloudflare, atau aplikasi. Lihat dulu: servernya masih hidup nggak, origin bisa dibuka nggak, dan link Ethernet-nya berhenti putus-nyambung belum?
Kadang ngurus homelab memang begini. Sudah punya Docker, tunnel, VPN, dan domain sendiri. Tetap bisa dibikin repot oleh satu sambungan kabel.
Makasih Codex buat nemenin baca log dan ngerakit monitornya. Makasih juga Cloudflare Workers dan Telegram: sekarang setidaknya ada yang ngabarin kalau rumah digital gue susah dikunjungi.
Cheers (dan kali ini kabel LAN-nya gue cek lagi), Agung Sukariman